


成長チームは、メッセージングが弱いために取引をするだけでなく、長くて面倒な運用によって取引を進めます。一般的な運用上の現実: HubSpot CRM が導入されている場合でも、収益チームは燃え尽きてしまう可能性があります。 週の最大 ~20% 手動データ入力、CSVインポート、およびフィールドの破損または重複が発生した後の「クリーン」作業。 これにより、カスタムWebフォーム、サードパーティのディレクトリ、イベントCSV、コールドソースのスプレッドシートやスクレイピングエクスポーなど、チャネル全体で複合的な無駄が発生します。
隠れたコストは リードまでのスピード。リードが何時間も処理されずに放置されたり、適切なプロパティなしで HubSpot に到達したりすると、ファネルから静かにリークが発生します。このガイドは、次への完璧なパスを示します。 ハブスポットのリード管理 そして ハブスポットのリードジェネレーション 実際のシステムのように動作する自動化: 外部リードを獲得し、それらを重複排除します。 リードジェネレーションCRMをクリックすると、手動でコピーすることなく、電子メール シーケンスが即座にトリガーされます。
EasyClaw は自動化ブリッジとして機能します。外部ソースからリードデータを抽出して正規化し、ペイロードを強化して、信頼できる形式で HubSpot にプッシュします。
問題: 手動データ入力の罠とデータの減衰
ほとんどのチームには HubSpot の「問題」はありません。彼らは、 プロセス 問題。手動の Hubspot リード管理は通常、次の 4 つの場所で中断されます。
- 人的データ入力エラー: 名前のスペルが間違ったり、電子メールのタイプが間違ったり、電話の形式が不一致になったりします (「(555)555-5555」と「5555555555」)。 HubSpot はゴミを喜んで保管します。後で、それらのレコードはルーティングできなくなります。
- フィールドのドリフトと壊れたマッピング: マーケティングチームは、リードソースフィールドが確実に入力されていると想定しているかもしれませんが、インポートされたCSVでは、ワークフローが想定しているものとは異なる列名が使用されている可能性があります。 鉛源, キャンペーン、 または セグメント 空白のままでは、自動化はパーソナライズできません。
- 静かに増殖する重複レコード: 一般的な Webhook セットアップと単純なインポートでは、安定した一意のキーが強制されないため、重複が作成されることがよくあります。信頼性の低いもの (会社名など) で結合すると、分析ではすべてが「本物」に見える複数の連絡先が作成されることになります。
- 運用上のボトルネックによるフォローアップの遅れ: データセットをレビューまたは変換する必要があるたびに、リードまでの速度のタイマーがリセットされます。 RevOps では、この遅延が重要です。メールのファーストタッチ シーケンスが、「温かい関心」と「すでに進んでいる」の違いです。
現在、1回限りのCSVインポートや脆弱な自動化を使って外部リードを取り込んでいる場合、重複のリスクがあるだけでなく、継続的な修正が必要で拡張できないパイプラインを構築するリスクもあります。
オートメーション アーキテクチャ ブループリント (ビジュアル ワークフロー)
これをシステムレベルのブループリントとして使用します。目標はシンプルです。すべての外部リードがクリーンな重複排除された HubSpot 連絡先となり、正しい電子メール シーケンスに即座に登録されます。
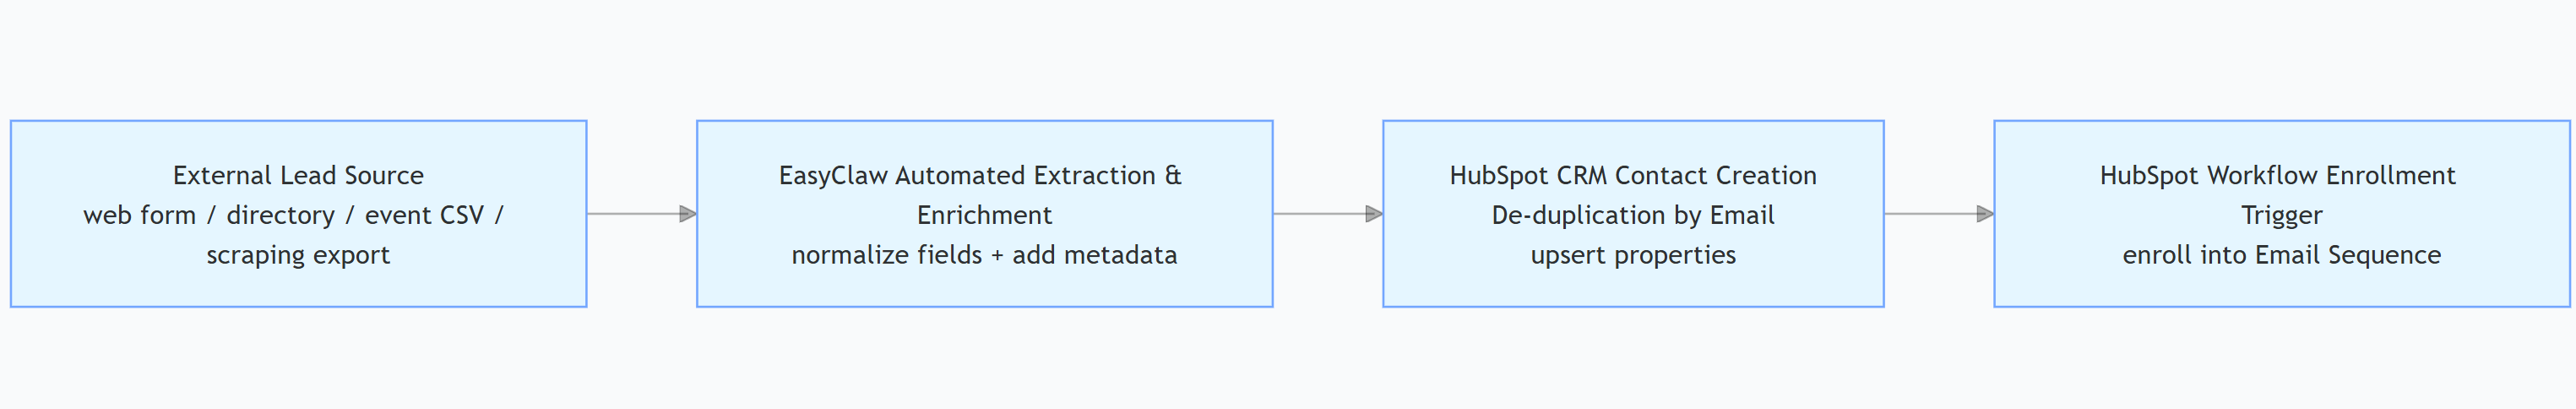
ステップバイステップ: HubSpot リード管理の自動化 (キャプチャ → 重複排除 → メールのトリガー)
ステップ 1: 外部のリードソースを検討し、データをクリーンにキャプチャする
まず、すべての外部ソースを、最終的な CRM 連絡先ではなく、「記録草案」を出力するかのように扱い始めます。自動化する前に、受信チャネルと各チャネルが提供する生のフィールドをリストします。一般的な例は次のとおりです。
- カスタムページからの Web リード (多くの場合、構造化された会社の詳細が欠落している)
- サードパーティのディレクトリ (名前の形式が一貫していない場合や、電話番号が見つからない場合があります)
- イベント CSV 暴露 (実行ごとに列名が異なる場合があります)
- スクレイパーからのコールド エクスポート (データ品質のばらつき、コンテキストの欠落、電子メールの一貫性の欠如)
北極星は、HubSpot Contact プロパティに合わせた統合ペイロードです。 実際には、これは次のフィールドを上流 (または抽出中の EasyClaw 内) で標準化する必要があることを意味します。
- 電子メール (重要な一意識別子)
- ファーストネーム
- 苗字
- 会社
- 電話 (オプションですが、ルーティングには役立ちます)
- 鉛源 (例:
EasyClaw_Automationと基礎となる外部チャネル) - キャンペーン・イベント (セグメンテーション用)
- 業界/役割/セグメント (確実に推測できる場合のみ)
- キャプチャタイムスタンプ (分析とSLA追跡用)
チームが失敗するのは、正規化されていないデータをそのまま Hubspot リード管理に押し込む場合です。 名/姓/メールアドレス/会社を一貫して統合しないと、データベースが汚染され、不完全なコンテキストに基づいてワークフローがトリガーされます。
ステップ 2: EasyClaw を使用して HubSpot データの取り込みを自動化する
このデータギャップを効果的に行うために、プロセスはまず EasyClaw から抽出と正規化を処理させて、次に HubSpot でサポートされている API/Webhook メカニズムを使用してクリーンなペイロードを HubSpot に配信します。
EasyClaw の仕事は「コピー&ペーストの自動化」ではありません。信頼できるものです データパイプライン:
- 抽出する 外部ソース(構造化フォームフィールドまたは非構造化ページ/エクスポート)からのリードの詳細。
- ノーマライズ HubSpot に合わせたプロパティ セットに追加します (空白のトリミング、電子メールの大文字と小文字の標準化、名前を姓/名にマップ、電話番号のフォーマット)。
- 豊かにする 可能な場合は (ソース チャネル、キャンペーン タグ、キャプチャ時間などのメタデータを追加します)。
- 押す HubSpot への「upsert のような」操作として、新しい場合は作成、既存の場合は更新します。
HubSpot 側で最も重要な概念は、取り込みロジックが決定論的である必要があるということです。つまり、EasyClaw は常に同じプロパティ名と同じセマンティクスを生成する必要があります。
Hubspot リード管理のための実際的な HubSpot 戦略は次のようになります。
email→ お問い合わせ 電子メール 財産firstname→ お問い合わせ ファーストネームlastname→ お問い合わせ 苗字company→ お問い合わせ 会社名 (または 会社 関連付け戦略 (設定に応じて)phone→ お問い合わせ 電話番号lead_source→ お問い合わせ 鉛源 (制御された値のセットを選択します)campaign→ お問い合わせ キャンペーン (またはカスタム プロパティ)external_source→ お問い合わせ 外部リード源 (カスタム)captured_at→ お問い合わせ リード獲得日 (SLAを追跡する場合はカスタム日時)
EasyClaw は、CRM の継続性を考慮した方法でこの値を HubSpot に送信します。 すでに HubSpot ワークフローを使用していて、安定したオーケストレーション モデルが必要な場合は、通常、ワークフローが登録トリガーとして使用する 1 つ以上のプロパティを設定または更新するように EasyClaw を構成します。
主要な運用の詳細: 取り込みペイロードが実行間で異なる値を設定しないようにしてください。 ちなみに、リードが別のソースから再摂取された場合、「リードソース」に最新のチャネルを反映するか、元のチャネルを反映するか決定します。自動化にはデータの移動だけでなく、ビジネスルールも必要です。
EasyClaw が受信ペイロードをフォーマットすると、HubSpot はプロパティの更新を正しい連絡先レコードに適用することで取り込みを処理します。選択した重複排除ルール (一意の識別子として Email) によって、HubSpot がレコードをマージするか、新しいレコードを作成するかが決まります。
ステップ 3: 自動重複排除と電子メール シーケンス トリガーのセットアップ
ここで、パイプラインに使用料を支払わせることができます。重複を排除して、すぐに電子メール シーケンスをトリガーします。
偶然客発掘 CRMワークフローでは、 メールは一意の識別子ですEasyClaw が連絡先ペイロードを送信するとき、HubSpot がメールによっての連絡先と照合し、コピーではなくプロパティを更新できるように HubSpot を構成します。
HubSpot では、通常、メールをキーとした HubSpot の連絡先/更新/挿入動作に依存し、自動化が常に有効な電子メール文字列を提供するように強制することでこれを実現します。名前や会社だけを重複排除しないでください。
次に、登録トリガーを実装します。クリーンなパターンは、取り込み中に制御されたプロパティ (または制御された値) を設定し、そのプロパティがリードの「準備ができている」ことを示した場合にのみ、HubSpot ワークフローを使用して順番に登録することです。
たとえば、EasyClaw の取り込み中に、次のように設定できます。
- 鉛源 =
EasyClaw_Automation - 自動化ステータス =
Enrolled_Pending(カスタム単一選択) - オプションで: 電子メールシーケンスターゲット =
Seq_SaaS_Nurture(単一選択)
次に、次のようなトリガーを使用して HubSpot ワークフローを作成します。
- 登録トリガー: 「施設に連絡するとき」 鉛源
EasyClaw_Automationに等しい」
または、さらに安全です: - 「施設に連絡するとき」 自動化ステータス
Enrolled_Pendingに変更します」
これが重要な理由: すべてのレコードに対して「Lead Source = EasyClaw_Automation」が設定されている場合、間違って連絡先を繰り返し登録してしまう可能性があります。信頼性の高いアプローチは、単一状態のステータスプロパティと、登録後にその状態を反転するワークフローです。
同じワークフロー内で、次のアクションを追加します。
- 連絡先を HubSpot に登録します 電子メールのシーケンス
- セット 自動化ステータス
Enrolledへ (ワークフローは再度登録されません) - オプションでログを記録します 外部リード源 そして キャンペーン 報告用
実際には、これは、ワークフローに「自動化ステータスが登録されていない場合のみ登録する」などのガード条件を含めるか、最初の実行の一部としてステータスを更新する必要があることを意味します。
以下は、実稼働環境で見られる典型的なプロパティ駆動ロジックです。
- EasyClaw はリードのプロパティを設定/更新します
- HubSpot ワークフロー登録トリガーは、更新されたプロパティに対してすぐに起動されます
- ワークフローはシーケンス登録を送信し、
Automation Status = Enrolledを設定します。 - ステータスがすでにマークされているため、その後の取り込み更新によってシーケンスが再トリガーされることはありません
徹底比較: 手動CSVインポートと自動ハイブリッドルーティング
選択は「すべてを自動化するかどうか」ではありません。選択は、データ管理操作にならずにパイプラインを拡張できるかどうかです。 Hubspot のリード管理をマスターする際の 2 つのアプローチをどのように比較するかは次のとおりです。
| 寸法 | 手動CSVインポート | 自動ハイブリッド ルーティング (EasyClaw → HubSpot) |
|---|---|---|
| 1週間あたりの滞在時間 | 高(エントリー+レビュー+逆輸入) | 低 (ハンズオフ取り込み + 一貫したマッピング) |
| リードの応答時間 | 多くの場合、何時間もかかります (人間の列 + 清掃) | 分 (即時キャプチャ → CRM 更新/挿入 → ワークフロー) |
| データの正確性 / 重複リスク | 高 (タイプミス、一貫性のない形式、弱い重複排除) | 低~中 (メール + 正規化されたフィールドによる重複排除) |
| 運用のスケーラビリティ | 悪い (ソースが増える = 手作業が増える) | 強力 (マッピング抽出ロジックによるソースの追加) |
| ワークフローの信頼性 | 壊れやすい (プロパティが欠落しているとトリガーが壊れる) | 安定(制御されたプロパティ値が登録を促進します) |
| レポートの一貫性 | パッチ状 (時間の経過とともに入力されるチャンネルが異なります) | コヒーレント (標準プロパティ + ソースタグ) |
通常、変曲点は、新しいリード ソースを追加した瞬間に到達します。手動プロセスは正常に劣化しません。それらはスプレッドシートと消火活動に分割されます。自動ルーティングが機能します。
なEasyClaw および HubSpot 技術スタック統合
EasyClaw は、マーケティング運用スタック全体を再構築する近く、みんなの HubSpot CRM 戦略に適合します。これは、制御を維持しながら手動コピーを削除するインフラストラクチャ エンジンのように動作します。
これが RevOps の用語で意味するのは次のとおりです。
- あなたの HubSpot のワークフロー ルーティング、セグメント化、電子メールの順序付けのための記録システムとして残ります。
- EasyClaw は、ハブスポットのリード生成データが確実に到着する自動化レイヤーになります すでに正規化されている、すでに属性が付けられており、すでに重複排除の準備ができています。
- チーム、チャネル、長期間インポート不一致によって行われる「CRM ドリフト」を排除します。
これは、無駄のないチームが企業運営のように機能する方法です。 CSV 列の不一致を追跡するのに時間を費やすのではなく、オファーとシーケンスの改善に時間を費やします。
インテグレーションのベストプラクティス: EasyClaw が設定する連絡先プロパティ、HubSpot ワークフローがリッスンする値、および自動登録の重複を防ぐプロパティを決定します。これらの契約が安定していれば、動けば Hubspot のリード管理が必要とされる予測可能性が得られます。
結論と実行可能なCTA
Hubspot リード管理の自動化は、賢いスクリプトや 1 回限りの Webhook に関するものではありません。 それは、「データ管理者」の仕事からパイプラインの速度に労力を移すことです。断片化された外部ソースからリードを取得し、EasyClaw で正規化、メールを使用して HubSpot で重複を排除し、正しい電子メール状況を瞬時にトリガーすると、ファネルの漏れが停止します。
手動の CSV インポートを完全なパイプラインに置き換える準備ができる場合は、まず、外部リード ソースとワークフローがする依存 HubSpot プロパティの概要を説明します。次に、制御された登録トリガー プロパティを使用して一貫したペイロードを出力するカスタム EasyClaw 抽出ワークフローを実装します。
CTA: HubSpot のリード獲得自動化に EasyClaw を試し、カスタムの抽出から HubSpot への取り込みワークフローを設定して、HubSpot ワークフロー登録トリガーを EasyClaw が設定するプロパティに合わせます。 2 番目の視点が必要な場合は、より多くのリードソースに拡張する前に、重複排除ルール、プロパティ面、電子メールシーケンス登録ロジックを検証するために、RevOps コンサルティングを当社チームに予約してください。