


AI ルーティングによる Speed-to-Lead 自動化
EasyClaw は、ボトルネックを自動ルーティング エンジンで置き換えます。 Web の Webhook フォームを待って監視し、LLM セマンティック トリアージを実行してリードを分類し、最適な営業担当者に即座に選択します。目標はシンプルです。生のインバウンド リードをほぼゼロのレイテンシで実行可能なサイト信号に変換し、適切なニーズがアイドル状態にならないようにすることです。
このアプローチは、キーワードのみのルールの脆弱性も回避します。 AIは購入意図、企業背景、価値層などのニュアンスを処理し、Webhookは信頼性と速度を処理します。
問題: 従来のリード配線が壊れている理由
人間は大規模な場合に十分迅速に行動できないため、手動トリアージは失敗します。チームが規律を保っていても、受信量が急増すると遅延が発生します。こうした遅延により、コンバージョン率を決定するまさにその瞬間にリスクが集中します。
キーワードの一致は別の理由で失敗します。意図を意味ではなく、固定パターンとして扱います。同じ問い合わせでも、業界、企業の段階、技術環境に応じて、購入者の緊急性が異なる場合があります。静的なラウンドロビン ロジックではアカウントの価値が理解できないため、厳格なルーティングではエンタープライズ アカウントをジュニア担当者に誤って割り当てる可能性もあります。
運用運用チームは、CRM パイプライン内でこれを最も感じます。適格なインバウンド ライセンス顧客が参入しますが、正しいすべての権利パスには到着しません。その結果、「確保」と「実行可能」は同じではないため、フォローアップの停止、継続性のない SLA、偏ったレポートが発生します。
RevOpsには、リードをフリーズさせる代わりに、受信コンテキストを理解して瞬時に動作するルーティング層が必要です。その層はイベント駆動型で、構造化されており、境界で決定的であることが必要です。
アーキテクチャ: 高レベルの技術データ フロー
この自動承認を開始するには、Web サイト、Webhook リスナー、AI 分類、ルーティング先の間で明確なデータ契約が必要です。この契約を設計する最も簡単な方法は、すべての受信イベントを、生のフィールドと派生プロパティの両方を持ち運び型付きペイロードとして扱うことです。
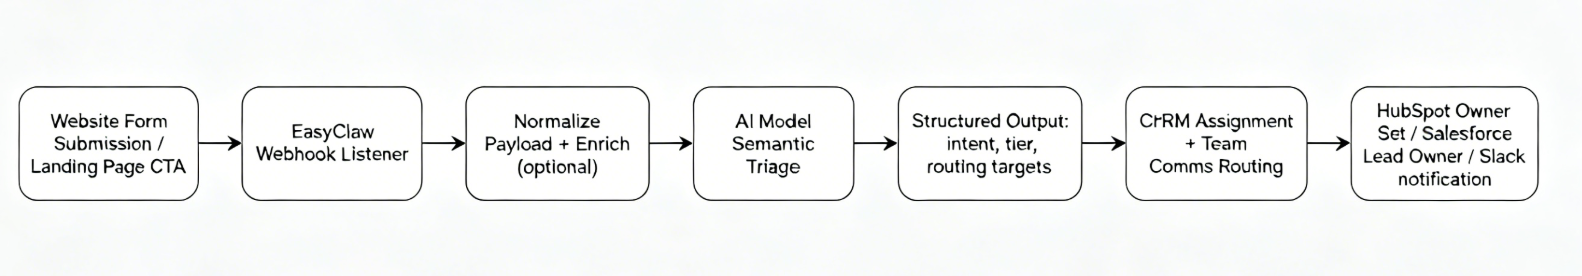
受信ペイロードがインターセプトされると、データ遷移は自然にセマンティック分析に流れます。 AI ステップは自由形式の会話であってはなりません。ルーティング ロジックが信頼できる制約付きスキーマを返す必要があります。
段階的な実装ブループリント
ステップ 1: EasyClaw Webhook リスナーのデプロイ
エンジニアリングチームは、まず受信フォーム送信が発生した瞬間にそれを傍受する必要があります。 EasyClaw は Webhook リスナーとして機能するため、Web サイトとランディングページはバッチポーリングなしでイベントを投稿できます。 これにより、送信、CRM 作成、内部通知間のタイミングのずれが解消されます。
まず、制御するすべての入力フィールドをマッピングします。一般的なフィールドには、会社名、電子メール ドメイン、役職、連絡先名、国、製品への関心、および自由記述の「メッセージ」フィールドが含まれます。キャンペーン ソース、ページ スラグ、A/B バリアントなどの非表示のメタデータもキャプチャする場合は、それを含めます。このコンテキストにより、セマンティック トリアージの精度が向上します。
次に、AI エンジンに送信するペイロードの形状を定義します。フィールド名を正規化して、プロンプトと解析ロジックを安定させます$。フォームが進化した場合は、ペイロードをバージョン管理します。入力が安定すると、構造化された出力解析の失敗率が減少します。
信頼性が重要であるため、Webhook 配信をエンジニアリング システムとして扱います。冪等キーを使用して、クライアントが再試行する際の重複した処理を防ぎます。リクエストの認証を追加して、承認されたソースのみがペイロードを送信できるようにします。受信リードをサイレントにドロップするのではなく、障害が配信できないキューまたは監視されたフォールバック パスにルーティングされるようにされます。
リスナーはイベントを受信すると、すぐに受信を確認し、非同期で処理を続行する必要があります。このパターンにより、全体的なレイテンシーを低く抑えながら、フォームからのタイムアウトが防止されます。
ステップ 2: AI 意味分類エンジンの設計
脆弱なキーワードマッチングに依存する代わりに、優れたアプローチには、迅速な設計と保留された出力が含まれます。 LLM は意味を分類し、ルーティングの決定を反映する構造化フィールドを出力する必要があります。
あなたのビジネスにとって「意図」が何を意味するかを定義します。たとえば、「評価」、「価格設定」、「統合」、「パートナーシップ」、「サポート」を区別することができます。 「価値層」が何を意味するのかを、マーケティング用語ではなく運用用語で定義します。販売範囲に関連付けられた階層がある場合は、それらの階層定義をプロンプトで直接使用します。
次に、同じ操作言語でファーモグラフィックを定義します。業種別およびおおよその企業規模の範囲を含めます。ドメインからのエンリッチメント データがある場合は、オプションでそれも渡します。 AI はそれを使用できますが、すべてを推測する必要はありません。
プロンプトでは、会話型テキストをわかりやすく禁止する必要があります。厳密なスキーマに一致する JSON 出力が必要です。スキーマには、自動化で追加の解釈なしで使用できるルーティング決定キーが含まれている必要があります。
一般的な構造化された結果には、予測された意図、信頼度スコア、業界、サイズ層、および「assignment_strategy」フィールドが含まれます。また、システムが明らかなジャンク$を抑制できるように、「spam_or_low_quality」フラグも必要です。
ばらつきを減らすには、正しい JSON 形式とルーティング動作を示す例をプロンプトに含めます。
最後に、出力検証を実装します。 AI の応答がスキーマに適合しない場合は、拒否し、修正された命令で再試行するか、人間のレビュー キューにルーティングします。あなたはチャットボットを構築しているのではありません。あなたは決定論的なトリアージ ゲートを構築しているのです。
ステップ 3: インテリジェントなルーティングと販売割り当ての実行
AI 出力を構造化すると、ルーティングは決定論的なマッピング問題になります。自動化レイヤーは、AI の意図と階層フィールドを、企業のテリトリー所有者や特定の営業チームのキューなど、正しい割り当てターゲットに変換する必要があります。
中心的なルールは、所有権については階層が 1 番目であり、フォローアップ パスについては意図が 2 番目です。企業の責任者は、直ちに第一層のアカウント幹部に連絡を取る必要があります。つまり、ルーティング ロジックは「価値層」出力を確認し、正しい所有者プールを選択する必要があります。リードが低品質またはスパムとマークされている場合は、割り当てを抑制し、拒否ワークフローをトリガーします。
誤った割り当てを回避するには、信頼度のしきい値のガードレールを追加します。信頼性が高い場合は、自動的にルーティングされます。信頼性が境界線に達している場合は、監査のために保存された AI の説明とともに「適格レビュー」キューにルーティングされます。これにより、所有権の正確性を犠牲にすることなく、変換速度が維持されます。
ルーティング先もイベント駆動型である必要があります。 CRM 割り当ての場合は、統合に基づいて HubSpot または Salesforce のすべての権利フィールドを更新します。チームコミュニケーションの場合は、リードの概要と AI 由来の根拠フィールドを含む標準化された通知を Slack チームまたは Microsoft チームに投稿します。
ベストプラクティスは、生のペイロードと構造化されたAI出力の両方を記録システムに保存することです。これにより、後のQA、モデルのチューニング、RevOpsレポートが可能になります。また、自動化をエンドツーエンドで監査できるため、EEAの期待もサポートされます。
最後に、ルーティングの変更が追跡されていることを確認します。後でリードを再分類する場合は、前後の状態を記録します。これにより、アトリビューションのドリフトが防止され、パイプライン分析が信頼できるものになります。
比較表: 手動/静的トリアージ と. EasyClaw AI ルーティング
違いはスピードを追求した自動化だけではありません。これは、セマンティック ルーティングの品質と、予測可能な配信メカニズムを組み合わせたものです。
| 能力 | 手動/静的トリアージ | EasyClaw AI ルーティング |
|---|---|---|
| 処理速度 | 手動レビューまたはバッチ CRM サイクルにより遅延 | Webhook リスナーによるリアルタイム実行 |
| 意図の認識 | 厳格なキーワード一致または人間の推測 | フルコンテキストを評価する LLM セマンティック分析 |
| アカウントの割り当て | 値や層を無視したブラインドラウンドロビン | 決定的な階層優先自動マッピング |
| スパムの軽減 | アクティブな販売キューを手動で埋める | 分類フラグによって自動的に抑制される |
| 監査証跡 | 一貫性のないメモと追跡されていない変更 | 生データと構造化データをエンドツーエンドで保存 |
なまず EasyClaw 統合 (RevOps エンジン)
EasyClaw は、受信リードイベントを吸収し、ペイロードを正規化、AI セマンティック トリアージを実行して、結果をルーティングするバックエンド RevOps エンジンとして扱う必要があります。この設計により、マーケティング サイトを軽量に絞りながら、信頼性とセキュリティを 1 つの制御されたレイヤーに集中させることができます。
スムーズに統合するには、まずはフォームとランディング ページを EasyClaw Webhook に接続します。次に、CRM とコミュニケーション ツールを接続して、構造化されたルーティング出力を受信します。重要なのは、AI スキーマから CRM 全権モデルへの集中したフィールドを確保することです。
セキュリティは後付けではなく、統合設計の一部である必要があります。 Webhook の概念を検証し、エンドポイントを制限し、CRM の書き込みに最小限の特権権利を適用します。 また、割り当てロジックが冪等性を考慮して、再試行、重複、部分的な失敗を処理する方法も決定します。
統合すると、割り当て率を超えた成果を測定できます。送信から最初の所有者のアクションまでの時間、人間の QA サンプルに対するルーティングの精度、意図と層ごとのダウンストリーム コンバージョンを追跡します。そのデータは、ガードレールの迅速な調整と配線のためのフィードバックとなります。
結論と実行可能な行動喚起
これは、事後対応的な販売から、データに基づいた即時的なリード実行への移行です。リード ルーティングの自動化を自動化しているだけではありません。あなたは、意図がまだ勢いがある間に、インバウンドのリードを割り当てられた所有権に変換するリアルタイムの意思決定パイプラインを設計しています。
RevOps チームが信頼できるアーキテクチャが必要な場合は、まずはイベント駆動型 Webhook リスナーをデプロイし、次に構造化 LLM 出力を強制し、層モデルに定められたガードレール付きのレーダーロジックを実装します。