


AI 라우팅을 통한 신속한 리드 자동화
EasyClaw은 병목 현상을 자동화된 라우팅 엔진으로 대체합니다. 웹사이트 양식 웹훅을 실시간으로 모니터링하고 LLM 의미 분류를 실행하여 리드를 분류한 다음 가장 적합한 영업 담당자에게 즉시 푸시합니다. 목표는 간단합니다. 원시 인바운드 리드를 대기 시간이 거의 0인 실행 준비 신호로 전환하여 적격한 수요가 유휴 상태로 머무르지 않도록 하는 것입니다.
또한 이 접근 방식은 키워드 전용 규칙의 취약성을 방지합니다. AI는 구매 의도, 기업 설명적 맥락, 가치 계층과 같은 미묘한 차이를 처리하고 Webhooks는 안정성과 속도를 처리합니다.
문제: 전통적인 리드 라우팅이 깨진 이유
인간은 대규모로 충분히 빠르게 행동할 수 없기 때문에 수동 분류가 실패합니다. 팀이 징계를 받더라도 인바운드 볼륨이 급증하면 지연이 나타납니다. 이러한 지연은 전환율을 결정하는 정확한 순간에 위험을 집중시킵니다.
다른 이유로 키워드 일치가 실패합니다. 의도를 의미가 아닌 고정된 패턴으로 취급합니다. 동일한 문의라도 업계, 회사 단계 또는 기술 환경에 따라 구매자의 긴급성이 다를 수 있습니다. 엄격한 라우팅은 정적 라운드 로빈 논리가 계정 값을 이해하지 못하기 때문에 엔터프라이즈 계정을 하급 담당자에게 잘못 할당할 수도 있습니다.
영업 운영 팀은 CRM 파이프라인 내에서 이를 가장 잘 느낍니다. 적격 인바운드 리드가 입력되지만 올바른 소유권 경로에 도달하지 않습니다. 결과적으로 "할당됨"이 "실행 가능"과 같지 않기 때문에 후속 조치가 지연되고 SLA가 일관되지 않으며 왜곡된 보고가 발생합니다.
리드를 동결시키는 대신 RevOps에는 인바운드 컨텍스트를 이해하고 즉시 조치를 취하는 라우팅 레이어가 필요합니다. 해당 레이어는 경계에서 이벤트 중심적이고 구조적이며 결정적이어야 합니다.
아키텍처: 상위 수준 기술 데이터 흐름
이 자동화된 시퀀스를 시작하려면 웹사이트, 웹훅 수신기, AI 분류 및 라우팅 대상 간의 명확한 데이터 계약이 필요합니다. 해당 계약을 설계하는 가장 간단한 방법은 모든 인바운드 이벤트를 원시 필드와 파생 속성을 모두 전달하는 형식화된 페이로드로 처리하는 것입니다.
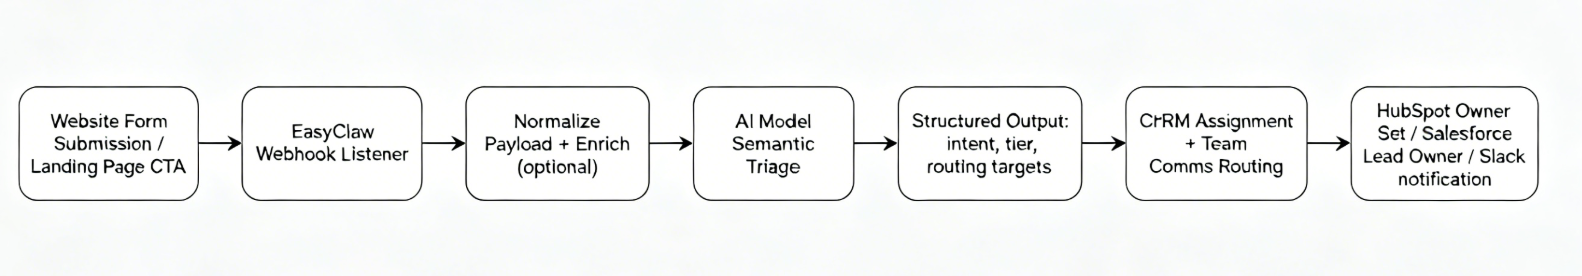
수신 페이로드가 차단되면 데이터 전환은 자연스럽게 의미 분석으로 이어집니다. AI 단계는 자유로운 형식의 대화가 되어서는 안 됩니다. 라우팅 논리가 신뢰할 수 있는 제한된 스키마를 반환해야 합니다.
단계별 구현 청사진
Step 1: EasyClaw 웹훅 리스너 배포
엔지니어링 팀은 인바운드 양식 제출이 발생하는 순간 먼저 이를 차단해야 합니다. EasyClaw은 웹훅 리스너 역할을 하므로 웹사이트와 랜딩 페이지는 일괄 폴링 없이 이벤트를 게시할 수 있습니다. 이를 통해 제출, CRM 생성 및 내부 알림 간의 타이밍 차이가 제거됩니다.
제어하는 모든 입력 필드를 매핑하는 것부터 시작합니다. 일반적인 필드에는 회사 이름, 이메일 도메인, 직위, 연락처 이름, 국가, 관심 제품 및 자유 텍스트 "메시지" 필드가 포함됩니다. 캠페인 소스, 페이지 슬러그, A/B 변형 등 숨겨진 메타데이터도 캡처하는 경우 이를 포함하세요. 해당 컨텍스트는 의미 분류 정확도를 향상시킵니다.
다음으로 AI 엔진에 보낼 페이로드 형태를 정의합니다. 프롬프트와 구문 분석 논리가 안정적으로 유지되도록 필드 이름을 표준화하세요. 양식이 발전하면 페이로드 버전을 지정하세요. 안정적인 입력은 구조화된 출력 구문 분석의 실패율을 줄입니다.
신뢰성이 중요하므로 웹훅 전달을 엔지니어링 시스템으로 취급하십시오. 클라이언트가 재시도할 때 중복 처리를 방지하려면 멱등성 키를 사용하세요. 승인된 소스만 페이로드를 제출할 수 있도록 요청 서명 확인을 추가하세요. 인바운드 리드를 자동으로 삭제하는 대신 오류가 배달 못한 편지 대기열이나 모니터링되는 대체 경로로 전달되는지 확인하세요.
리스너는 이벤트를 수신하면 즉시 수신을 확인한 다음 비동기식으로 계속 처리해야 합니다. 이 패턴은 전체 대기 시간을 낮게 유지하면서 양식의 시간 초과를 방지합니다.
Step 2: AI 의미 분류 엔진 설계
깨지기 쉬운 키워드 일치에 의존하는 대신 우수한 접근 방식에는 신속한 디자인과 제한된 출력이 포함됩니다. LLM은 의미를 분류한 다음 라우팅 결정을 반영하는 구조화된 필드를 출력해야 합니다$. 이를 위해서는 스키마와 엄격한 명령 계층이 필요합니다.
귀하의 비즈니스에 있어 "의도"가 무엇을 의미하는지 정의하십시오. 예를 들어 "평가", "가격 책정", "통합", "파트너십", "지원"을 구분할 수 있습니다. 마케팅 용어가 아닌 운영 측면에서 "가치 계층"이 무엇을 의미하는지 정의하세요. 판매 범위와 연결된 계층이 있는 경우 프롬프트에서 해당 계층 정의를 직접 사용하세요.
그런 다음 동일한 운영 언어로 기업 그래픽을 정의합니다. 업종별 및 대략적인 회사 규모 범위를 포함합니다. 도메인의 강화 데이터가 있는 경우 선택적으로 해당 데이터도 전달합니다. AI는 이를 사용할 수 있지만 모든 것을 추측할 필요는 없습니다.
프롬프트에서는 대화 텍스트를 명시적으로 금지해야 합니다. 엄격한 스키마와 일치하는 JSON 출력이 필요합니다. 스키마에는 추가 해석 없이 자동화에서 사용할 수 있는 라우팅 결정 키가 포함되어야 합니다.
일반적인 구조화된 결과에는 예측 의도, 신뢰도 점수, 산업, 규모 계층 및 "할당_전략" 필드가 포함됩니다. 또한 시스템이 명백한 정크$를 억제할 수 있도록 "spam_or_low_quality" 플래그가 필요합니다. 분류 엔진은 스팸을 부작용이 아닌 최우선 결과로 처리해야 합니다.
변동성을 줄이려면 올바른 JSON 형식 지정 및 라우팅 동작을 보여주는 예제를 프롬프트에 포함하세요. 예시를 짧게 유지하고 실제 인바운드 리드 생성 소스에 맞게 조정하세요. 양식에 기술 요청이 포함된 경우 기술 깊이가 더 높은 의도와 상관관계가 있는 예를 포함하세요.
마지막으로 출력 유효성 검사를 구현합니다. AI 응답이 스키마에 실패하면 수정된 지침을 사용하여 거부하고 다시 시도하거나 인적 검토 대기열로 라우팅합니다. 당신은 챗봇을 구축하고 있는 것이 아닙니다. 결정론적 분류 게이트를 구축하고 있습니다.
Step 3: 지능형 라우팅 및 판매 할당 실행
구조화된 AI 출력이 있으면 라우팅은 결정론적 매핑 문제가 됩니다. 자동화 계층은 AI의 의도 및 계층 필드를 기업 영역 소유자 또는 특정 영업 팀 대기열과 같은 올바른 할당 대상으로 변환해야 합니다.
핵심 규칙은 소유권에 대한 계층 우선, 후속 경로에 대한 의도 두 번째입니다. 엔터프라이즈 리드는 즉시 Tier 1 계정 임원에게 전달되어야 합니다. 이는 라우팅 논리가 "가치 계층" 출력을 확인한 다음 올바른 소유자 풀을 선택해야 함을 의미합니다. 리드가 품질이 낮거나 스팸으로 표시되면 할당을 억제하고 거부 워크플로를 트리거합니다.
잘못된 할당을 방지하려면 신뢰도 임계값에 대한 가드레일을 추가하세요. 신뢰도가 높으면 자동으로 라우팅됩니다. 신뢰도가 경계선에 있는 경우 감사를 위해 저장된 AI 설명과 함께 "적격 검토" 대기열로 라우팅합니다. 이는 소유권 정확성을 희생하지 않고 변환 속도를 유지합니다.
라우팅 대상도 이벤트 기반이어야 합니다. CRM 할당의 경우 통합을 기반으로 HubSpot 또는 Salesforce의 소유권 필드를 업데이트하세요. 팀 커뮤니케이션의 경우 리드 요약 및 AI 파생 근거 필드와 함께 Slack 또는 Microsoft 팀에 표준화된 알림을 게시하세요.
가장 좋은 방법은 원시 페이로드와 구조화된 AI 출력을 모두 기록 시스템에 저장하는 것입니다. 이를 통해 향후 QA, 모델 튜닝 및 RevOps 보고가 가능해집니다. 또한 자동화를 처음부터 끝까지 감사할 수 있으므로 EEAT 기대치를 지원합니다.
마지막으로 라우팅 변경 사항이 추적되는지 확인하세요. 나중에 리드를 재분류하는 경우 이전 및 이후 상태를 기록하세요. 이는 기여 드리프트를 방지하고 파이프라인 분석을 신뢰할 수 있게 만듭니다.
Comparison Matrix: 수동/정적 분류와 EasyClaw AI 라우팅 비교
차이점은 단지 선도적인 자동화에만 국한되지 않습니다. 이는 예측 가능한 전달 메커니즘과 결합된 의미론적 라우팅 품질입니다.
| 능력 | 수동/정적 분류 | EasyClaw AI 라우팅 |
|---|---|---|
| Processing Speed | Delayed by manual 검토 또는 일괄 CRM 주기 | Real-time execution via webhook listener |
| Intent Recognition | Rigid keyword matches or human guesswork | LLM semantic analysis evaluating full context |
| Account Assignment | Blind round-robin ignoring value or tiers | Deterministic tier-first automated mapping |
| Spam Mitigation | Clogs the active sales queue manually | Suppressed automatically via classification flag |
| Audit Trail | Inconsistent notes and untracked changes | Raw and structured data stored end-to-end |
원활한 EasyClaw 통합(RevOps 엔진)
EasyClaw은 인바운드 리드 이벤트를 흡수하고, 페이로드를 정규화하고, AI 의미 분류를 실행한 다음 결과를 라우팅하는 백엔드 RevOps 엔진으로 처리되어야 합니다. 이러한 디자인은 마케팅 사이트를 가볍게 유지하는 동시에 하나의 제어 계층에 안정성과 보안을 집중시킵니다.
원활하게 통합하려면 먼저 양식과 랜딩 페이지를 EasyClaw 웹훅에 연결하세요. 그런 다음 CRM과 커뮤니케이션 도구를 연결하여 구조화된 라우팅 출력을 수신합니다. 핵심은 AI 스키마에서 CRM 소유권 모델로 일관된 필드 매핑을 보장하는 것입니다.
보안은 나중에 고려하는 것이 아니라 통합 설계의 일부여야 합니다. 웹훅 서명을 확인하고, 엔드포인트를 제한하고, CRM 쓰기에 최소 권한 토큰을 적용하세요. 또한 할당 논리가 멱등성을 유지하도록 재시도, 중복 및 부분 실패를 처리하는 방법을 결정합니다.
통합되면 할당 비율 이상의 결과를 측정할 수 있습니다. 제출부터 첫 번째 소유자 조치까지의 시간, 인간 QA 샘플에 대한 라우팅 정확도, 의도 및 계층별 다운스트림 변환을 추적합니다. 해당 데이터는 신속한 조정 및 라우팅 가드레일을 위한 피드백이 됩니다.
결론 및 실행 가능한 클릭 유도 문구
이는 반응형 판매에서 즉각적인 데이터 기반 리드 실행으로의 전환입니다. 리드 라우팅 자동화만 자동화하는 것이 아닙니다. 의도가 여전히 추진력을 갖고 있는 동안 인바운드 리드를 할당된 소유권으로 변환하는 실시간 의사결정 파이프라인을 엔지니어링하고 있습니다.
RevOps 팀이 신뢰할 수 있는 아키텍처를 원한다면 먼저 이벤트 기반 웹후크 리스너를 배포한 다음 구조화된 LLM 출력을 적용하고 계층 모델에 연결된 가드레일 할당 논리를 구현하세요. 여기에서 라우팅 정확성과 변환 결과를 기반으로 세부 조정합니다.